В эксперименте с участием человека с БАС активность 256 корковых микроэлектродов превращалась в слышимый голос. Важный результат касается интонации и обратной связи во время попытки говорить.
Пауза, которую трудно выразить печатным текстом
При тяжёлой дизартрии человек может сохранять намерение сформулировать фразу, хотя дыхательная, гортанная и артикуляционная системы уже не позволяют произнести её разборчиво. Печатный интерфейс обеспечивает коммуникацию, однако привычные компоненты разговора приходится передавать дополнительными действиями. Вопрос и утверждение могут различаться одним движением голоса. Ударение меняет смысл предложения, а короткая пауза подсказывает собеседнику, что мысль продолжается. При последовательном выборе букв эти признаки теряются либо кодируются медленнее, чем разворачивается диалог.
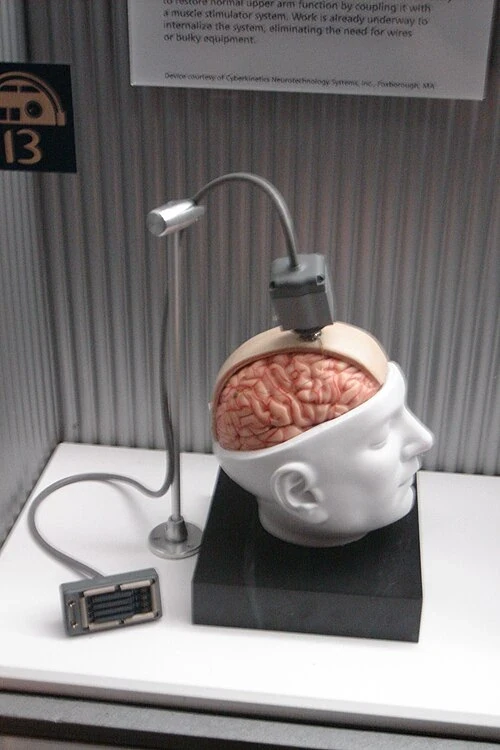
В июне 2025 года исследовательская группа продемонстрировала преобразование корковой активности в голос у мужчины с боковым амиотрофическим склерозом и тяжёлой дизартрией. Система использовала сигналы 256 микроэлектродов в вентральной части прецентральной извилины. Участник пытался произносить предъявленные фразы и слышал синтезированную речь с малой задержкой. В отдельных заданиях он менял интонацию и воспроизводил короткие мелодические последовательности. Масштаб результата важен именно как демонстрация принципа у одного человека. По нему пока нельзя оценить вероятность успешной коммуникации в широкой группе пациентов.
Где образуется сигнал для декодирования
В моторной коре активность групп нейронов связана с попыткой управления движениями речевого аппарата. Электродная матрица регистрирует изменения в ограниченной области ткани. Декодер использует их временную структуру для оценки параметров будущего звука. Далее синтезатор создаёт акустический сигнал, а участник получает возможность услышать результат. Операция требует точного совмещения событий во времени. В разговоре важен не только выбранный звук, но и то, когда он начался, как долго длился и как перешёл в следующий.
Это принципиально отличает речевой интерфейс от системы, которая позволяет выбрать заранее подготовленное сообщение. Если при печати пользователь может проверить всё слово до отправки, синтезируемый голос разворачивается во времени и сразу доступен слушателю. Ошибка в начале фразы уже прозвучала, даже если следующий фрагмент распознан правильно. Поэтому при разработке возникает отдельная задача управления началом, окончанием и исправлением сообщения. Для человека, который только осваивает интерфейс, предсказуемое поведение системы может оказаться важнее естественного тембра.
Как обучать синтез, когда эталонная речь недоступна
Обычный алгоритм распознавания можно обучать на парах «аудиозапись — текст». У человека с тяжёлой дизартрией попытка артикуляции не сопровождается пригодной для этой цели звуковой дорожкой. Декодеру требуется установить соответствие между нейронными событиями и ожидаемой структурой звука при неизвестном точном темпе. В протоколе использовали задания с известными фразами и разработали способ обучения при отсутствии полноценной произнесённой речи. Этот момент особенно существенен при оценке воспроизводимости. Другая группа пациентов может отличаться остаточной артикуляцией, утомляемостью и способностью стабильно воспроизводить задание.
Синтезировали голос с чертами голоса участника до заболевания. Здесь разделяются два слоя технологии. Декодирование определяет, какую последовательность человек пытается создать в данный момент. Модель голоса задаёт, кому будет похож выходной акустический сигнал. Сходство тембра само по себе не доказывает правильность сообщения. В лабораторной оценке полезно независимо проверять разборчивость для незнакомого слушателя, точность содержания и возможность управлять выразительностью.
Что показывают контрольные задания
| Задача | Какой компонент проверяет | Что остаётся установить |
|---|---|---|
| Предъявленная фраза | Согласование последовательности звуков с намерением | Качество свободного диалога |
| Изменение интонации | Управление частью просодии | Стабильность при усталости и смене задания |
| Слушание чужой речи | Специфичность запуска интерфейса | Поведение в бытовой акустической среде |
| Повторная сессия | Стабильность регистрации и настройки | Готовность к регулярной работе дома |
Когда человек слышит сгенерированный голос, микрофон, вибрация или слуховая реакция могут создать дополнительные корреляции. Для убедительной демонстрации исследователям необходимо исключить ситуацию, при которой система в действительности улавливает остаточный звук или реагирует на речь другого человека. Особенно важны контрольные эпизоды с посторонней речью и с вокализацией вне попытки произнести задание. Они помогают установить происхождение сигнала. При этом единичная лабораторная проверка не исчерпывает всех помех обычного дома или больничной палаты.
Тест на изменение высоты звука отвечает на иной вопрос, чем оценка точности слова. Возможность поднять голос к концу фразы делает вопрос узнаваемым, даже если порядок слов одинаков. Умение воспроизвести короткую мелодию свидетельствует о доступе к некоторым параметрам высоты и времени. Оно не даёт основания заявлять о возврате всего диапазона выразительного пения. Для медицинской публикации важно указывать само задание и условия исполнения, чтобы читатель понимал смысл демонстрации.
Условный разговор у постели пациента
Представим просьбу повторить последнюю фразу врача. Текстовый терминал позволяет сформировать грамматически точное сообщение, но требуется время, и собеседник может начать следующий вопрос. При немедленном синтезе пользователь получает шанс вступить в нужный момент и обозначить сомнение интонацией. Одновременно возрастает цена непреднамеренного запуска. Для клинической эксплуатации нужно знать, как пациент останавливает ошибочную реплику, как обозначает готовность говорить и кто подтверждает смысл сообщения в ситуации, требующей ответственного решения.
Практическая пригодность зависит также от длительности сеанса, стабильности качества после перерыва и времени настройки персоналом. В лаборатории инженер способен обнаружить изменение одного канала и повторить калибровку. Дома за системой ухаживает сам пользователь, родственник или подготовленный специалист, а штатный разговор может начаться без предупреждения. Поэтому число верно распознанных слов на коротком сеансе следует дополнять долей времени, когда интерфейс готов к работе, частотой коррекций и нагрузкой на человека.
Слово распознано, а намерение выразить вопрос потеряно
Для проверки выразительности можно предъявить одинаковую последовательность слов в двух ситуациях. В первой говорящий уточняет, закончена ли процедура, во второй сообщает об этом как о факте. Незнакомый слушатель сначала определяет, какие слова он услышал, а затем выбирает коммуникативный смысл. Если содержание распознано верно в обеих записях, а вопросительный вариант систематически воспринимается как утверждение, слабым звеном оказывается передача просодии. Обычная метрика количества ошибок в словах такую проблему может вовсе не заметить.
Другая проверка касается громкости и темпа. Для оценки технической модели удобно выровнять уровень записи, чтобы эксперты сравнивали одинаковые условия. Для оценки реально слышимой речи полезно сохранить и исходный вариант, который получит собеседник в комнате. Разница становится заметной, когда синтезатор передаёт более тихую реплику или когда человек намеренно делает длинную паузу. Автоматическое сокращение паузы способно улучшить формальный показатель скорости и одновременно лишить высказывание смысла. Поэтому в протоколе испытания следует заранее указать, оценивают ли речь как акустический файл либо как часть взаимодействия двух людей.
Наконец, при разговоре право на исправление принадлежит самому пользователю. Для будущего клинического интерфейса важно предусмотреть понятный сигнал, позволяющий сказать, что распознанное сообщение не соответствует намерению. Когда это требуется во время обсуждения медицинского решения, второй независимый способ подтверждения смысла сохраняет ценность даже при очень высокой разборчивости синтезированного голоса.
Отдельно оценивают способность начать высказывание после долгого молчания. В диалоге человек не обязан постоянно поддерживать активность, чтобы сохранять управление. Полезный интерфейс должен различать отсутствие намерения говорить, паузу внутри фразы и намеренное завершение сообщения. Одно и то же состояние тишины на выходе имеет в этих ситуациях разный смысл для собеседника. Именно здесь вопрос удобства превращается в измеримую задачу точности запуска и остановки.
Долговременный интерфейс как клиническая задача
Имплантируемый массив создаёт отдельные вопросы безопасности и стабильности регистрации. Необходимо проследить, как меняется сигнал со временем, какие процедуры требуются при неполадке и сохраняется ли возможность общения другим способом во время недоступности установки. По одному участнику невозможно заранее определить индивидуальную переносимость операции и ожидаемый выигрыш у людей с другим расположением импланта или другим характером поражения.
Значение разработки состоит в том, что слышимый результат стал частью замкнутой коммуникационной задачи. Человек не только инициировал попытку говорить, но и получал немедленную информацию о сформированном голосе. Следующим критерием зрелости будет устойчивое выражение собственных мыслей без заранее заданного текста, в свободном разговоре и на протяжении длительного времени. Именно эти наблюдения покажут, какие функции удалось вернуть пользователю в повседневной жизни.